
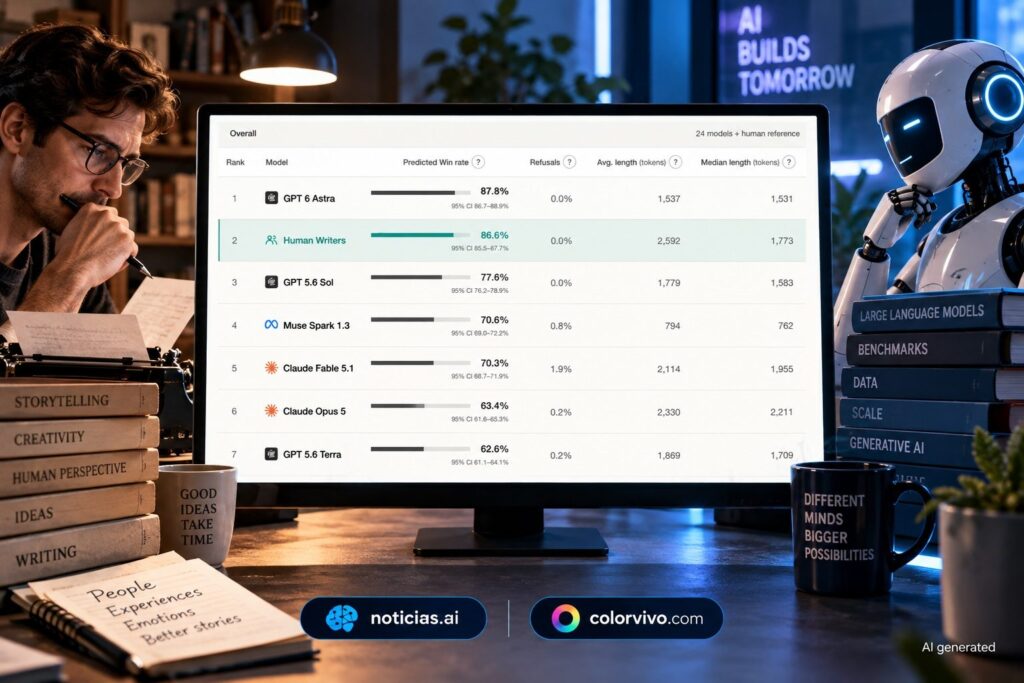
Un nuevo benchmark de Vulsar AI pone a prueba una de las áreas más difíciles de medir en inteligencia artificial: la escritura creativa. El estudio compara 24 modelos de IA con escritores humanos a partir de 475 prompts y muestra diferencias relevantes según el tipo de autor, con GPT 6 Astra en el primer puesto de la clasificación general con una tasa de victoria prevista del 87,8 %.
Las claves del benchmark de escritura creativa de Vulsar en 30 segundos
- Vulsar compara 24 modelos de IA con escritores humanos mediante 475 prompts de escritura creativa.
- GPT 6 Astra alcanza un 87,8 % de tasa de victoria prevista en el resultado general.
- La referencia de escritores humanos obtiene un 86,6 % en esa misma clasificación.
- Entre escritores aficionados, Astra llega al 93,9 %, mientras que los profesionales alcanzan un 99,9 % frente al 76,2 % del modelo.
- El estudio mide preferencia prevista de lectores, no una puntuación absoluta de calidad ni una prueba de originalidad.
El resultado tiene interés para empresas que utilizan inteligencia artificial generativa en marketing de contenidos, publicidad, redes sociales o producción editorial porque introduce una diferencia que suele quedar fuera de las comparativas de modelos: el rendimiento de una IA depende también del tipo de contenido y del nivel de especialización del profesional con el que se compara.
Para elaborar el benchmark, Vulsar no recurrió a otro modelo de lenguaje como juez. La compañía utiliza un modelo de recompensa entrenado con preferencias humanas sobre escritura creativa. Ese sistema compara las respuestas y calcula una tasa de victoria prevista para cada participante.
Qué modelos destacan en escritura creativa
La clasificación general coloca a GPT 6 Astra en primera posición con un 87,8 % de tasa de victoria prevista. La referencia formada por escritores humanos obtiene un 86,6 %, seguida por GPT 5.6 Sol con un 77,6 %.
| Modelo o referencia | Tasa de victoria prevista |
|---|---|
| GPT 6 Astra | 87,8 % |
| Escritores humanos | 86,6 % |
| GPT 5.6 Sol | 77,6 % |
| Muse Spark 1.3 | 70,6 % |
| Claude Fable 5.1 | 70,3 % |
| Claude Opus 5 | 63,4 % |
| GPT 5.6 Terra | 62,6 % |
| GPT 5.6 Luna | 61,8 % |
| Kimi K3 | 61,0 % |
| Grok 4.6 | 59,3 % |
La clasificación también muestra diferencias importantes en la extensión de los contenidos generados. Los escritores humanos alcanzan una media de 2.592 tokens, frente a los 1.537 tokens de GPT 6 Astra. Sin embargo, el estudio no establece que un texto más largo sea necesariamente mejor.
Para un equipo de marketing, esta distinción resulta especialmente relevante. Una herramienta puede generar textos que obtengan una alta preferencia en determinados escenarios y, al mismo tiempo, necesitar instrucciones más precisas, revisión editorial o adaptación al tono de una marca antes de su publicación.
La propia metodología de Vulsar tampoco convierte el porcentaje en una medida universal de calidad. El 87,8 % de Astra representa una tasa de victoria prevista dentro de las comparaciones realizadas en el benchmark.
La experiencia profesional cambia el resultado
Uno de los datos más interesantes para el sector del marketing aparece cuando Vulsar separa a los escritores profesionales de los aficionados.
En la categoría profesional, la referencia humana alcanza un 99,9 % de tasa de victoria prevista. GPT 6 Astra obtiene un 76,2 %, mientras Grok 4.6 se sitúa en el 78,5 %.
| Modelo o referencia | Escritores profesionales |
|---|---|
| Escritores humanos | 99,9 % |
| Grok 4.6 | 78,5 % |
| GPT 6 Astra | 76,2 % |
| Claude Fable 5.1 | 69,8 % |
| Muse Spark 1.3 | 64,9 % |
| Qwen3.8 2.4T A95B | 63,6 % |
| Claude Opus 5 | 63,3 % |
| GPT 5.6 Sol | 63,1 % |
El escenario cambia entre los escritores aficionados. GPT 6 Astra alcanza un 93,9 %, GPT 5.6 Sol un 85,2 % y la referencia humana se queda en el 79,7 %.
| Modelo o referencia | Escritores aficionados |
|---|---|
| GPT 6 Astra | 93,9 % |
| GPT 5.6 Sol | 85,2 % |
| Escritores aficionados | 79,7 % |
| Muse Spark 1.3 | 73,5 % |
| Claude Fable 5.1 | 70,5 % |
| GPT 5.6 Terra | 70,2 % |
| GPT 5.6 Luna | 67,4 % |
| Claude Opus 5 | 63,5 % |
La comparación es relevante para el marketing de contenidos porque muestra que no existe una única respuesta a la pregunta de si un modelo escribe mejor que una persona. El resultado cambia de forma sustancial dependiendo del perfil de referencia.
Qué significa el benchmark para marketing y contenidos SEO
Para los equipos de SEO y contenidos, el estudio aporta una conclusión práctica: la calidad de un contenido generado por IA no debería evaluarse únicamente por el modelo utilizado.
El prompt, el tipo de contenido, la experiencia del redactor y el proceso de revisión también forman parte del resultado. Un artículo informativo, una campaña publicitaria, una historia de marca o una publicación para redes sociales pueden exigir capacidades diferentes.
El benchmark de Vulsar tampoco analiza directamente factores habituales del SEO como posiciones en Google, tráfico orgánico, tasa de clics, conversiones, autoridad temática o visibilidad en buscadores. Por tanto, sus resultados no permiten afirmar que un determinado modelo vaya a generar automáticamente mejores resultados SEO.
Sí ofrece, en cambio, una referencia sobre la capacidad de los modelos para producir textos que un sistema entrenado con preferencias humanas considera atractivos dentro de un conjunto concreto de tareas.
Para las marcas, eso refuerza una idea sencilla: la IA puede formar parte del proceso de producción de contenidos, pero el benchmark no sustituye la evaluación del contenido según los objetivos de cada campaña.
Además, Vulsar señala una limitación relevante sobre la originalidad. El modelo de recompensa utilizado para la evaluación incorpora preferencias humanas relacionadas con la percepción de novedad, pero el benchmark no verifica de manera independiente si las ideas o formulaciones de las historias son realmente nuevas frente a textos existentes o frente a los datos utilizados durante el entrenamiento de los modelos.
Esto resulta especialmente importante en marketing, donde la diferenciación de una marca depende también del conocimiento del público, el posicionamiento, el tono y la capacidad de desarrollar mensajes propios.
Una métrica útil, pero no una prueba definitiva
Vulsar utilizó 475 prompts únicos y las mismas instrucciones para los modelos participantes dentro de cada conjunto de pruebas. El razonamiento se desactivó cuando era posible y, cuando no lo era, se empleó el nivel disponible más bajo. Las respuestas vacías o rechazos se excluyeron de la puntuación en lugar de contarlos como derrotas.
El sistema tampoco utiliza una rúbrica tradicional con varios apartados puntuados por un LLM. Vulsar emplea su modelo de recompensa para estimar qué respuesta tendría más posibilidades de ser preferida por un grupo amplio de lectores.
Eso hace que los resultados sean interesantes para estudiar la percepción de textos generados por IA, pero también marca sus límites. Una tasa de victoria elevada no equivale a mayor conversión, mejor posicionamiento SEO, mayor fidelidad a una guía de marca o mayor eficacia publicitaria.
La diferencia entre los resultados de escritores aficionados y profesionales es, de hecho, una de las señales más claras del estudio. Mientras GPT 6 Astra alcanza el 93,9 % frente a la referencia aficionada, la comparación con escritores profesionales se sitúa en el 76,2 % frente al 99,9 % humano.
Para el sector del marketing, el benchmark apunta así a una cuestión más concreta que la habitual competición entre modelos: qué tareas puede asumir una IA y en cuáles sigue siendo relevante la experiencia especializada de un profesional.
Preguntas frecuentes
¿Qué benchmark ha comparado modelos de IA con escritores humanos?
Vulsar AI ha publicado Creative Writing Bench V1, un estudio con 24 modelos de IA, escritores humanos y 475 prompts de escritura creativa.
¿Qué modelo obtiene el mejor resultado general?
GPT 6 Astra alcanza una tasa de victoria prevista del 87,8 % en la clasificación general de Vulsar, frente al 86,6 % de la referencia de escritores humanos.
¿Qué resultado obtiene GPT 6 Astra frente a escritores profesionales?
GPT 6 Astra registra un 76,2 % de tasa de victoria prevista en la categoría de escritores profesionales. La referencia humana profesional alcanza el 99,9 %.
¿Sirve este benchmark para saber qué IA es mejor para SEO?
No directamente. El estudio mide preferencia prevista sobre escritura creativa y no analiza posiciones en buscadores, tráfico orgánico, conversiones ni otros indicadores específicos de SEO.