
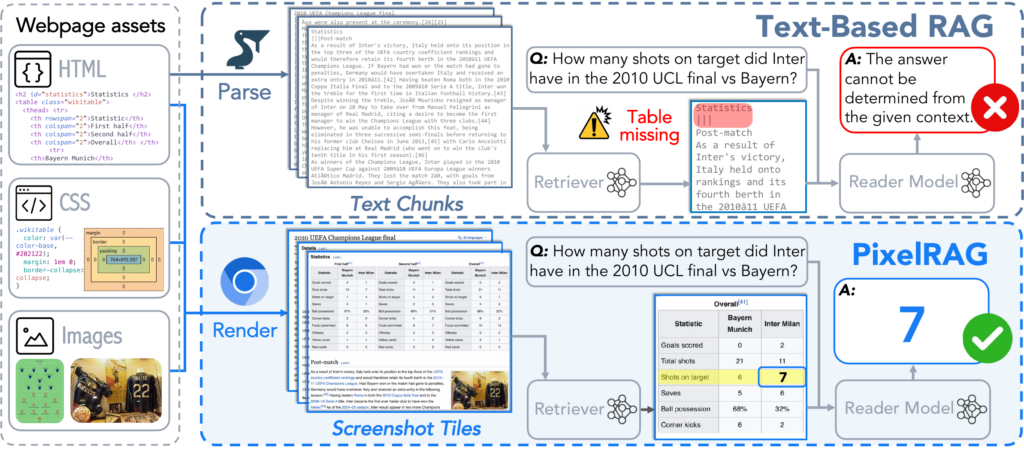
Un equipo de UC Berkeley ha publicado PixelRAG, un sistema de código abierto que, en lugar de convertir una página web en texto para que la lea un modelo de IA, la captura como imagen y deja que un modelo de visión y lenguaje busque y lea la respuesta directamente en los píxeles. Según su artículo científico, este enfoque mejora la precisión hasta un 18,1 % frente a los sistemas basados en texto en varias pruebas de preguntas y respuestas.
Las claves de PixelRAG, el RAG que lee webs como capturas, en 30 segundos
- Investigadores de UC Berkeley, Princeton, EPFL, Databricks y la Universidad Renmin firman el trabajo.
- Han indexado Wikipedia completa como capturas: 8,28 millones de artículos y unos 30 millones de imágenes en un índice de búsqueda visual.
- El código está en GitHub con licencia Apache 2.0 e incluye un plugin para que Claude Code lea páginas como imagen.
- La mejora de hasta el 18,1 % frente al RAG de texto es un máximo en pruebas concretas, no una media general.
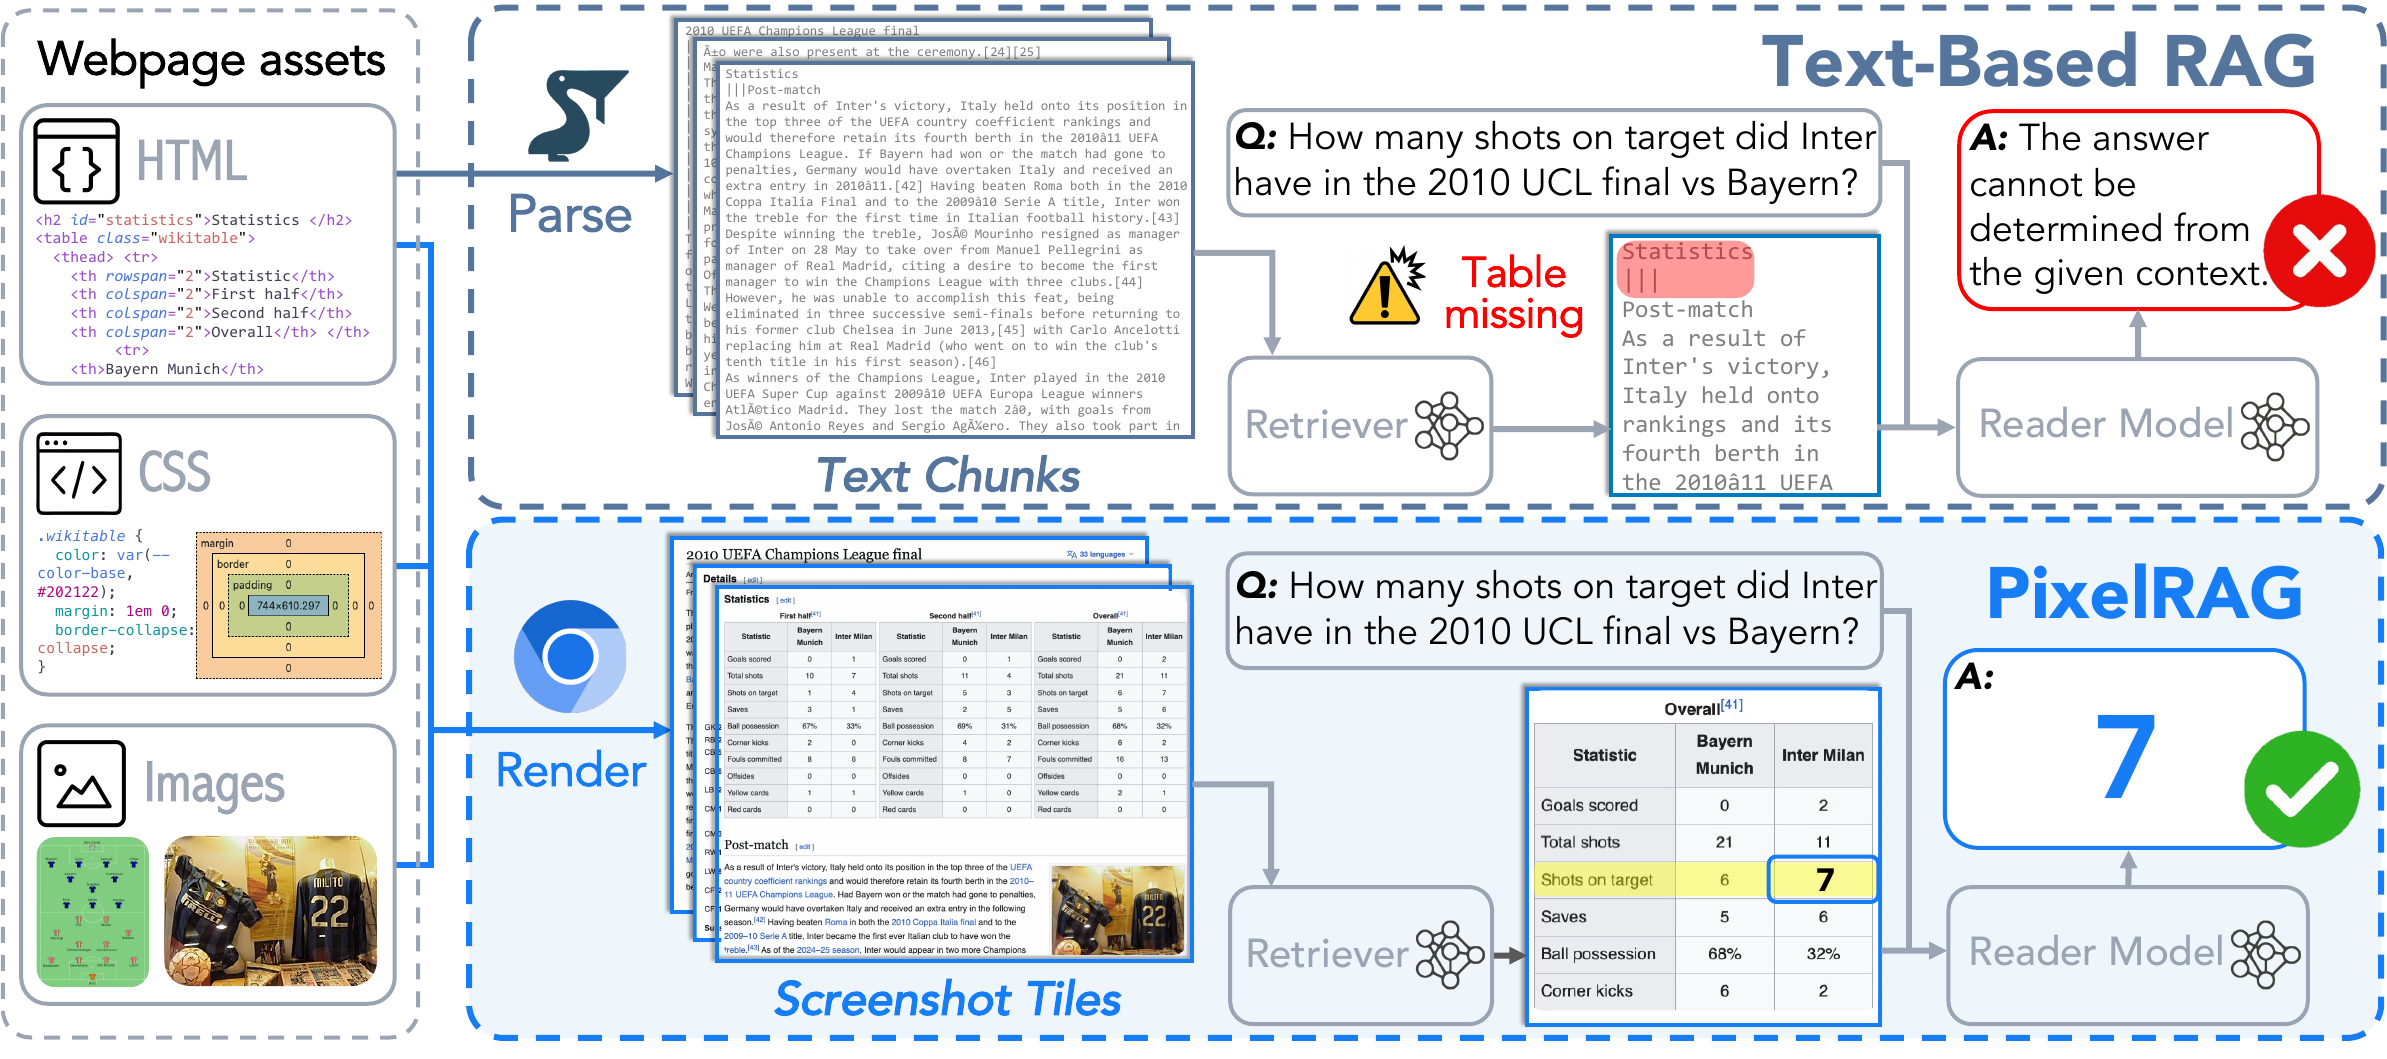
La técnica se apoya en la generación aumentada por recuperación (RAG, por sus siglas en inglés), el método con el que muchos asistentes buscan documentos antes de responder. Lo habitual es descargar el HTML, limpiarlo y trocearlo en fragmentos de texto. El artículo de PixelRAG sostiene que ese paso de análisis del HTML descarta el diseño, la estructura visual y el formato, y que con él se pierden datos de tablas, gráficos o maquetaciones en columnas. Su alternativa es renderizar la página como la vería una persona, dividirla en fragmentos de imagen y buscar sobre ellos.
Qué resultados presenta el estudio
Los autores parten de un modelo existente, Qwen3-VL-Embedding, y lo ajustan con datos de capturas de pantalla para que las imágenes de las páginas queden en un espacio donde se puedan recuperar por su contenido. Las capturas recuperadas se pasan después a un modelo de visión y lenguaje sin convertirlas antes en texto. Según el resumen del trabajo:
- Supera tanto a responder sin búsqueda como a los sistemas RAG de texto, incluso en pruebas pensadas para texto como Natural Questions y SimpleQA.
- Obtiene sus mayores ventajas en preguntas multimodales (MMSearch), en noticias con ruido (LiveVQA) y en tareas de agentes (MoNaCo), con mejoras de hasta el 18,1 %.
- Al reducir la resolución de las imágenes, recorta hasta tres veces el coste en tokens manteniendo la precisión.
Son resultados de un artículo publicado en arXiv por los propios autores, no de una evaluación independiente. El proyecto ofrece además una demo en línea y una API pública que consulta un índice ya construido de los 8,28 millones de artículos de Wikipedia.
Qué significa para quien publica contenido
PixelRAG es una investigación y no describe cómo funcionan hoy los buscadores ni los asistentes comerciales. Aun así, plantea una cuestión relevante para el SEO orientado a la IA: si un sistema lee la página como imagen, la información que está en una tabla, un gráfico o un bloque de diseño deja de perderse en la extracción de texto. En los sistemas basados en texto, en cambio, lo que no sobrevive al análisis del HTML no llega al modelo. Seocretos ya contó cómo Claude aplica un doble filtro al leer páginas web y cómo Gemini cita menos las páginas cuando solo recibe su meta description, dos ejemplos de que lo que el modelo recibe condiciona lo que cita.
Para equipos técnicos, el repositorio incluye la skill pixelbrowse para Claude Code, que hace capturas con pixelshot en lugar de descargar el HTML. Se instala así:
uv tool install pixelrag
claude plugin marketplace add StarTrail-org/PixelRAG
claude plugin install pixelbrowse@pixelrag-plugins
Después basta con pedir a Claude una captura de una URL, un artículo de arXiv o un PDF. Para construir un índice propio el sistema funciona en Linux con CUDA y en Mac con Apple Silicon, y usa FAISS como base vectorial por defecto, con Qdrant como alternativa. Descargar el índice base de Wikipedia, en cambio, supone unos 217 GB.
Preguntas frecuentes
¿Qué es PixelRAG?
Un sistema de recuperación aumentada que indexa páginas web, PDF e imágenes como capturas de pantalla y deja que un modelo de visión lea las respuestas directamente en ellas.
¿Quién ha creado PixelRAG?
Investigadores de UC Berkeley, con participación de Princeton, EPFL, Databricks y la Universidad Renmin, según su artículo en arXiv.
¿Cuánto mejora PixelRAG al RAG de texto?
Según sus autores, hasta un 18,1 % de precisión en algunas pruebas, como MMSearch, LiveVQA o MoNaCo. No es una mejora media en todos los casos.
¿Se puede usar PixelRAG con Claude Code?
Sí. El repositorio incluye la skill pixelbrowse, que permite a Claude hacer capturas de una página y leerlas como imagen.
Fuentes: