
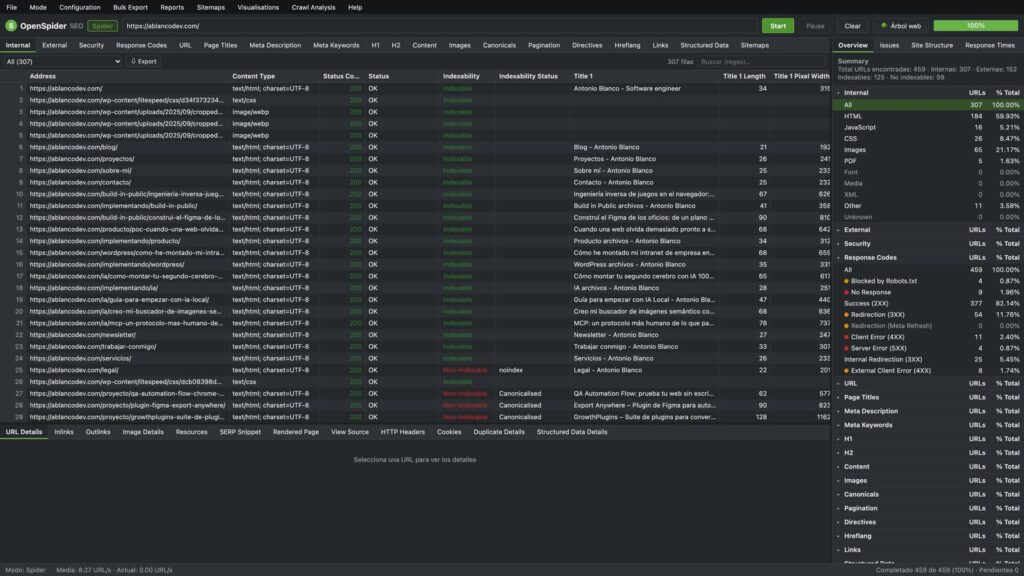
OpenSpider, un rastreador SEO publicado en GitHub por el desarrollador ablancodev, lleva al navegador buena parte del flujo de trabajo de los crawlers de escritorio: rastreo con robots.txt, más de 150 filtros, Link Score interno, detección de casi duplicados con MinHash y validación de hreflang. Se descarga gratis y funciona con un pequeño proxy en PHP, aunque todavía es un proyecto muy reciente.
Las claves de OpenSpider para SEO técnico en 20 segundos
- Rastrea en modo Spider o modo List, con hilos, retardo, límites de profundidad y reescritura de URL configurables.
- Analiza canonicals, hreflang, paginación, directivas, datos estructurados y cadenas de redirección, y calcula un Link Score interno.
- No ejecuta JavaScript, guarda los datos en la memoria del navegador y aún no incluye archivo de licencia.
En la parte técnica, OpenSpider tiene un alcance amplio para un proyecto escrito en HTML, CSS y JavaScript sin dependencias. El rastreador usa una cola en anchura con hilos concurrentes, interpreta robots.txt con la regla de coincidencia más larga y los comodines * y $, y registra cada salto de redirección por separado porque su proxy en PHP no las sigue de forma automática. Redes-sociales.com ya repasó qué puede revisar un equipo de marketing con OpenSpider; aquí el foco está en el SEO técnico.
Lo que analiza después del rastreo
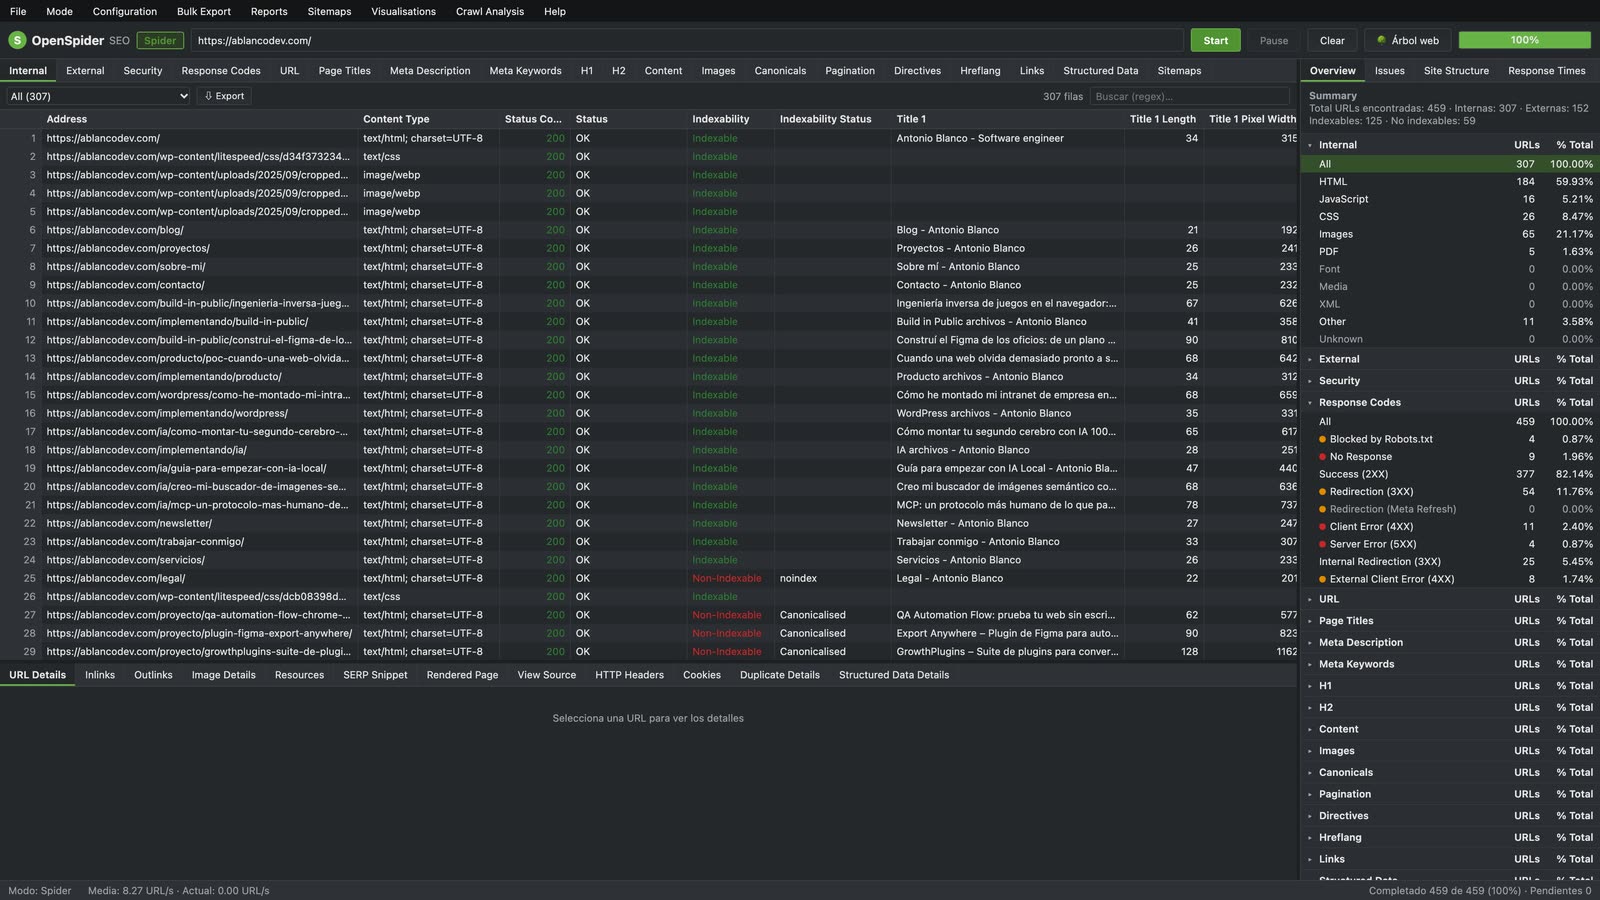
Al terminar, OpenSpider ejecuta un análisis del conjunto del sitio que va más allá de revisar URL sueltas:
- Link Score: un cálculo de PageRank interno para ver qué páginas reciben más autoridad del enlazado.
- Duplicados: exactos y casi duplicados, estos últimos con MinHash y LSH.
- Hreflang: validación de enlaces de retorno, códigos ISO y x-default.
- Páginas huérfanas: URL sin enlaces internos que lleguen a ellas.
- Informes: cadenas de redirección y de canonical, resumen SERP, tiempos de respuesta y un probador de robots.txt.
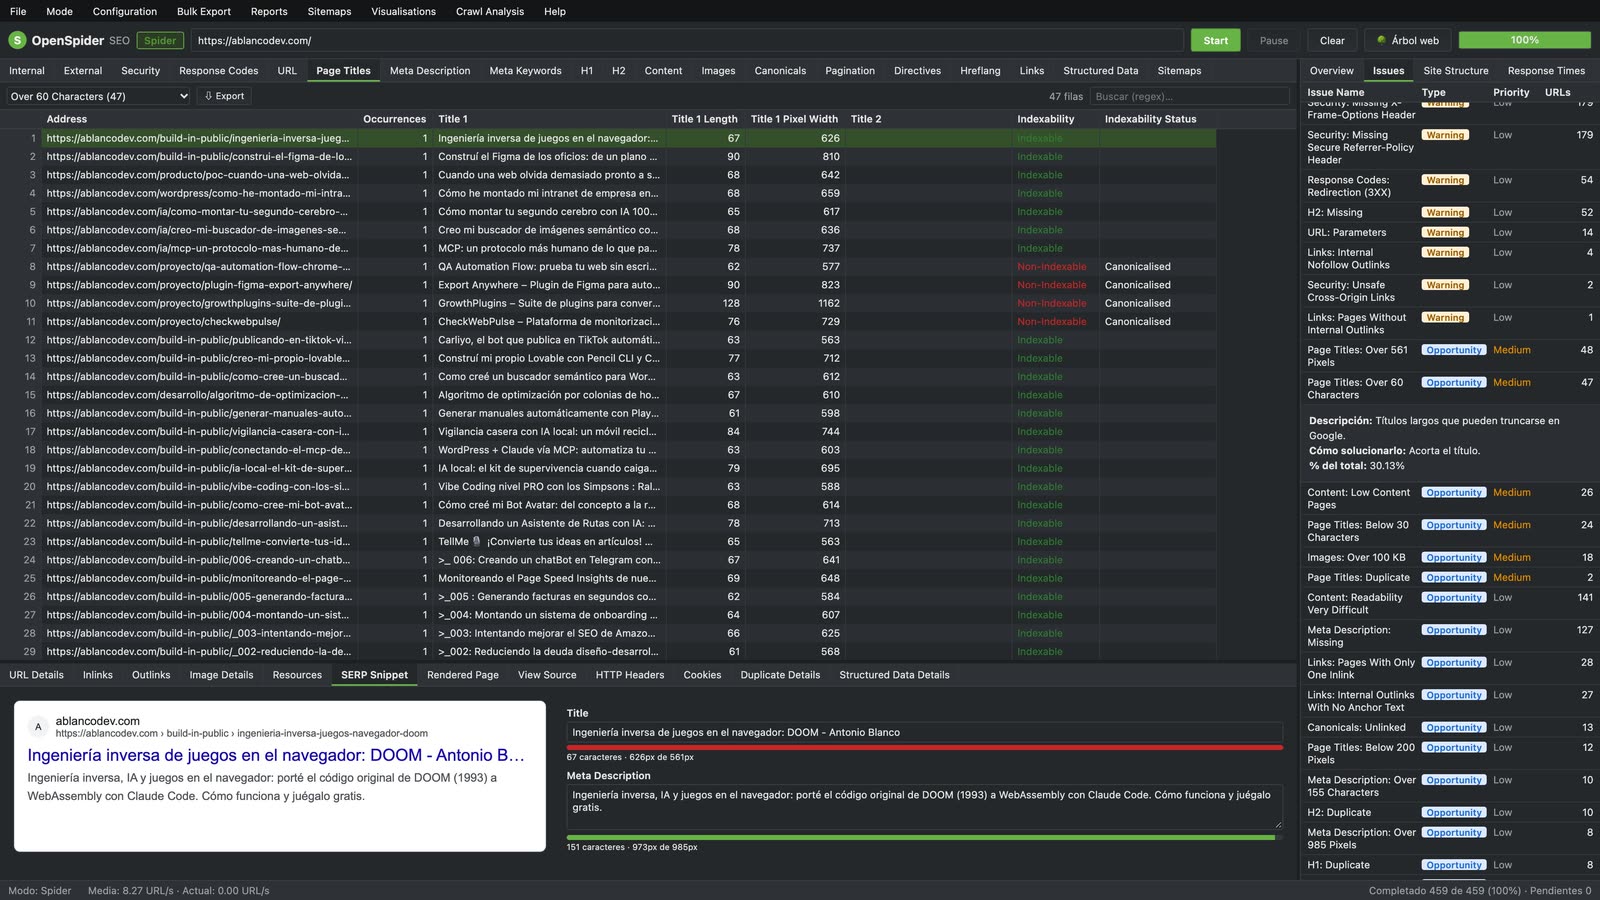
Cada URL tiene una ficha con inlinks, outlinks, imágenes, recursos, cabeceras HTTP, cookies, código fuente, página renderizada y JSON-LD. La vista previa del snippet es editable y mide título y descripción en píxeles, aunque el autor advierte de que esa medida es una aproximación. Los rastreos se guardan en archivos .ospider.json para abrirlos más tarde.
Límites antes de usarlo en un cliente
La principal limitación es que no ejecuta JavaScript. En sitios hechos con frameworks que pintan el contenido en el cliente, OpenSpider ve el HTML que sirve el servidor, igual que vería un bot que no renderiza. El renderizado con un navegador headless figura en su hoja de ruta, junto a integraciones con Search Console, Google Analytics y PageSpeed Insights, comparación entre rastreos y rastreos programados, pero son planes, no funciones disponibles.
Los datos viven en la memoria del navegador, y el autor lo recomienda para sitios de hasta unas decenas de miles de URL. Para webs grandes, un crawler de escritorio o en servidor sigue siendo más adecuado. Otro punto es el proxy: desde fuera de localhost funciona por defecto en modo demo, que solo descarga hosts con IP pública, limita puertos, tamaño y tiempo de respuesta y aplica un máximo de peticiones por minuto. El modo open elimina esas restricciones y el README desaconseja usarlo en un servidor público.
Por último, el proyecto está en una fase temprana: a 28 de octubre de 2026 tenía cinco commits y no incluía archivo de licencia, un detalle a revisar antes de modificarlo o integrarlo en herramientas propias. Seocretos explicó hace poco cómo ChatGPT descubre URL con datos de Cloudflare, otro caso en el que revisar robots.txt y el rastreo del propio sitio vuelve a ser trabajo básico.
Preguntas frecuentes
¿Qué analiza OpenSpider?
Códigos de respuesta, títulos, meta descriptions, encabezados, canonicals, hreflang, paginación, directivas, imágenes, enlaces, datos estructurados y sitemaps, entre otros.
¿OpenSpider renderiza JavaScript?
No. Analiza el HTML que sirve el servidor; el renderizado con un navegador headless está en su hoja de ruta.
¿Cuántas URL puede rastrear?
Guarda los datos en la memoria del navegador y su autor lo recomienda para sitios de hasta unas decenas de miles de URL.
¿Qué licencia tiene OpenSpider?
Su autor lo presenta como código abierto, pero a 28 de octubre de 2026 el repositorio no incluía archivo de licencia.
Fuentes: